写真によるカロリー推定
AIカロリー計算の仕組み、写真から出る3段階
AIカロリー計算の仕組みを、写真から数値が出る3段階と出典つきの誤差で解説します。見えない油やソースがなぜ数字に残るのか、確認の意味もわかります。
ガイド
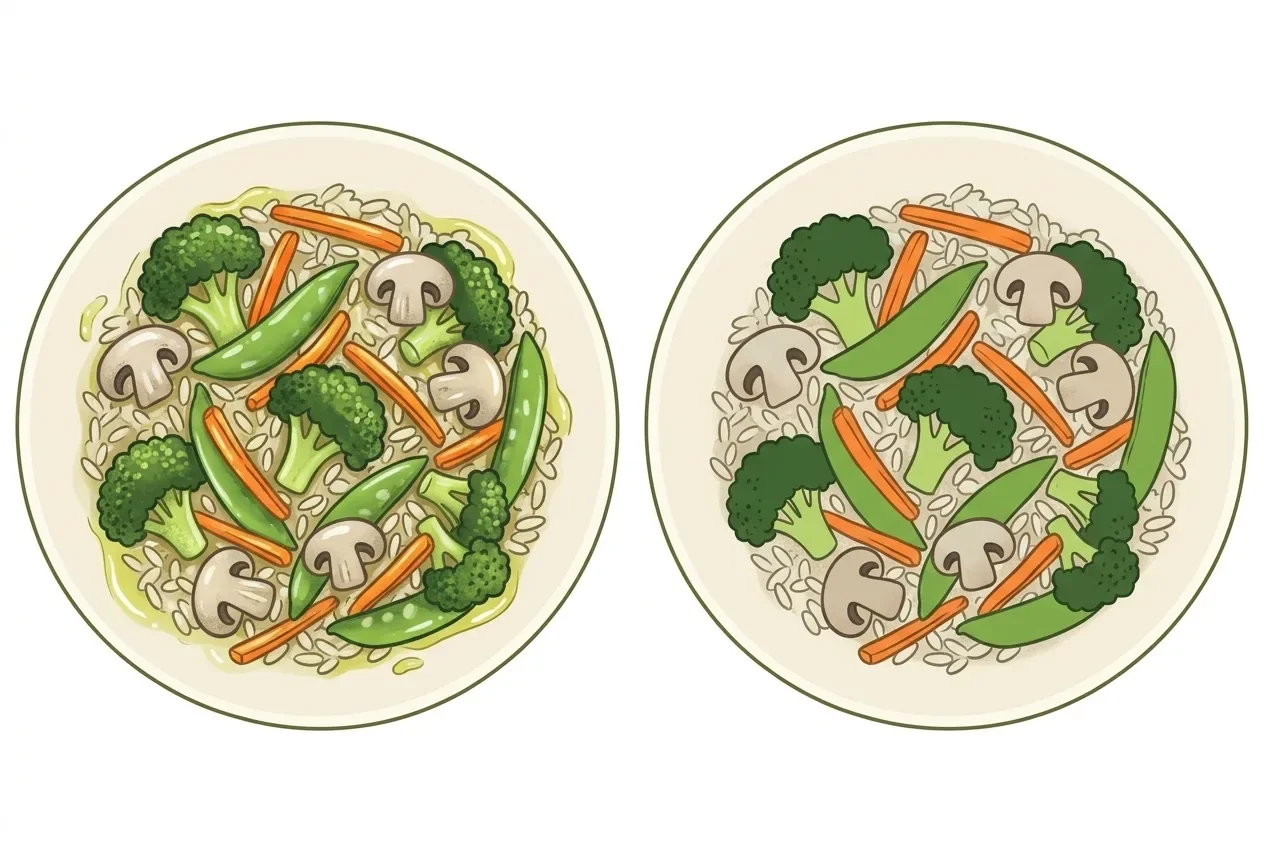
AIカロリー計算アプリの精度は、確実とは言えません。あくまで推定で、公表された研究では実測に近い場合もあれば、数百kcalずれる場合もあります。 ずれ方は偶然ではありません。アプリは総カロリーを少なく、脂質を多く見積もりがちです。写真には密度も重さも隠れた油も写らないためです。アプリの出来だけでなく、この仕組みがずれの大部分を説明します。
写真は、皿に当たった光を平面に写したものです。形、色、おおよその大きさはわかりますが、密度や重さ、ソースに何が混ざっているかはわかりません。
同じ見た目のご飯でも、強く詰めてあれば重さは変わります。油でつやつやの炒め物と、スプレーで炒めたものも、写真ではほとんど区別がつきません。例として示す仮の数字ですが、油大さじ2杯で約240 kcalになり、その分は写真に写りません。
そのため、写真をきれいに撮るだけでは問題は解決しません。カメラが捉えるのは光の様子で、はかりの数字ではないからです。1枚の画像からの推定は、画像に写らない部分を推測するしかありません。
AIの画像認識モデルが写真を見て、どんな食品があるかを判別します。そのうえで、皿の大きさ、食べ物の高さ、一般的な盛り付けの形との比較といった手がかりから、量を見積もります。
判別した食品と推定した量から、モデルがカロリーと栄養素の数字を直接出します。バーコードの読み取りやデータベース検索とは違い、この段階で実測値の表と照合することはありません。
そのあと、利用者がモデルの出した結果を確認します。食品名、量、数字は保存前に直せます。この確認があるから、写真の推定は単なる当て推量ではなく、記録として残るものになります。
「判別、推定、確認」という流れを知っておくと、どこで誤差が生じ、どこで自分の修正が効くのかが見えてきます。
2026年にNutrientsに載った研究では、病院の標準化された食事写真を使い、AIモデルと管理栄養士の推定を比べました。上位のChatGPT-4oとGemini 1.5 Proは、エネルギーと炭水化物で管理栄養士の値との相関が0.8を超え、多くは10%前後の差に収まりました(Nutrients、DOI 10.3390/nu18060966)。一方、すべてのモデルで脂質は平均20%を超える過大評価でした。たんぱく質もエネルギーより精度が落ちました。
理由は、カメラに何が見えるかに行き着きます。ご飯のような炭水化物の多い食品は、体積とカロリーの関係が比較的読みやすい食品です。脂質はソースに溶け込んだり、具材の下にたまったりして見えないことが多く、見た目だけで推測するモデルは補正しすぎる傾向があります。
総カロリーのずれを示す研究が、ほかに2つあります。1つ目はNUTRITION 2026で発表された予備的な結果です。MyFitnessPal、LoseIt!、CalAI、Appediet の4つの市販アプリを、材料を0.1 g単位で量った代謝キッチンの食事102食で試し、その後200食以上を追加で確認しました。アプリは1食あたり約250〜345 kcal、脂質は約30 g少なく見積もりました(EurekAlert、NIH/NIDDK)。この結果は予備的で、査読はまだ受けていません。
2つ目は、npj Digital Medicineの査読つき研究です。肥満のある女性を対象に、AIアプリのSNAQを、摂取エネルギーの基準とされる二重標識水法と比べました。アプリは1日の摂取量を平均817 kcal少なく見積もり、偏りは25%でした。測定された平均は1日3,004 kcalです。繰り返し測定の一致度はほぼゼロで、ICCは0.00でした(PMC、npj Digital Medicine)。
| 研究 | 条件 | 比較 | 結果 |
|---|---|---|---|
| NIH/NIDDK(予備的、NUTRITION 2026) | 量った代謝キッチンの食事102食と、その後確認した200食以上 | 市販アプリ4つと、実測した材料 | 250〜345 kcal少なく見積もり、脂質は約30 g少ない |
| npj Digital Medicine | 日常生活、肥満のある女性 | AIアプリ1つ(SNAQ)と二重標識水法 | 1日817 kcal少なく見積もり、25% |
| Nutrients | 標準化された病院の食事写真 | AIモデルと管理栄養士 | エネルギーは約10%以内、脂質は20%以上の過大評価 |
傾向としては、条件をそろえた1皿の写真ほど推定が近くなります。日常の、品数の多い食事ほど差が大きくなります。
印刷された栄養成分表示は写真の推定より確かに思えますが、その許容範囲には向きがあります。
日本では、食品に表示するエネルギーなどの項目は、消費者庁の食品表示基準で定められています。比較として米国のルールを見ると、FDAの21 CFR 101.9(g)で、カロリー、総脂質、飽和脂肪、トランス脂肪、コレステロール、ナトリウムはクラスIの栄養素です。これらは表示値の120%を超えてはいけませんが、少なく表示することを防ぐ下限はありません。
つまり米国の表示のカロリーは、実測値より最大20%高くなることが法的に許され、低くなることを止める規定もありません。たんぱく質、ビタミン、ミネラル、食物繊維はクラスIIで、表示値の80%以上が必要で、上限はありません。
表示が信頼できないという話ではありません。検査された規制対象の数字でも、正確さの保証ではなく、あらかじめ幅があるということです。写真の推定も表示も近似値で、誤差の出どころが違うだけです。
どちらの方法にも誤差はあります。手入力はデータベースを検索して量を入力するので、正しい項目を選べるか、自分で量を見積もれるかに左右されます。
写真記録はその作業をモデルに任せます。ただしモデルも、食べ物の重さをはかれず、料理の中身も見えないという同じ問題を抱えています。
マーカーを使う研究用アプリgoFOOD Liteの研究では、写真468枚のうち60枚、12.8%が撮影の不備で使えませんでした。基準マーカーが写っていない、皿全体が見えないといった理由です(JMIR mHealth and uHealth、DOI 10.2196/24467)。撮影ミスを減らすために作られた仕組みでも、AIモデルとは別に、こうした誤差の原因があります。
どちらの方法でも推測はなくなりません。違いは、推測するのが人の量の見積もりか、モデルの画像の読み取りか、という点です。
写真の推定は、確定した数字ではなく、素早い最初の見積もりとして扱うのが適切です。単純な1皿なら、Nutrientsの病院の研究のとおり、訓練された観察者の判断に近づきます。ソースや油を使った家庭の混ぜ料理では、NIH/NIDDKとnpj Digital Medicineの結果のとおり、差が広がりやすくなります。
結果をひそかに崩す要因は、次のとおりです。
手作りの料理でもっと確かな数字がほしいときは、レシピのカロリーを材料ごとに計算する方法のように、材料ごとに積み上げる方法があります。
ご飯のように調理で重さが変わる食材は、白米の炊飯前後の重量:生と調理後の換算で、量った重さをそろえて記録できます。見落としやすい炒め油や食卓で足すソースは、調理油のカロリー計算:大さじ1杯は約119 kcalで足し上げられます。
合計がわかったら、無料のレシピのカロリー計算ツール(1人分・100 gあたり)で、写真の推定に頼らず、できあがりを1人分に分けられます。
Avocaloの写真記録は、この記事で説明した仕組みで動きます。食事を撮影するか、ギャラリーから写真を選ぶと、AIの画像認識モデルが食品を判別し、量、カロリー、たんぱく質、炭水化物、脂質を画像から推定します。
この推定は、栄養データベースと照合したものではありません。アプリは食べ物の重さをはからず、隠れた油やソース、正確な量も見分けられません。結果は保存前に確認し、編集できます。
直接調べたい食品には、手入力の記録もあります。Open Food Facts、USDA FoodData Central、各国の食品成分表をもとにしたデータベースを検索でき、最近食べたものやよく食べるものも再利用できます。2つを併用すれば、1日の食事をどちらか一方よりも広くカバーできます。アプリはApp StoreとGoogle Playで探せます。Avocaloのアプリをダウンロードから確認してください。
確認された根拠はありません。ここで挙げた研究は、ある時点でのアプリの性能を調べたもので、繰り返し使うことで学習するかどうかは測っていません。使うほど習慣を覚えて精度が上がるという主張を確かめるには、別の研究が必要です。引用した研究では、使用期間と精度の関係は検証されていません。
引用した研究はこの方法を検証していないため、根拠のある答えはありません。研究が示しているのは、誤差の大部分が撮影のタイミングではなく、量と材料の見えやすさに左右されることです。皿全体がはっきり写った写真は、goFOOD Liteの研究が指摘した撮影ミスの問題に対処できます。
アプリごとに使うAIモデルが違うためです。Nutrientsの研究でも、同じ標準化された写真に対してモデルの間で実際に差が出ました。ChatGPT-4oとGemini 1.5 Proは管理栄養士の値との相関が0.8を超えましたが同一ではなく、脂質の過大評価の幅もモデルごとに異なりました。
常にそうとは限りません。手入力ならAIの推測はなくなりますが、正しいデータベースの項目を選び、量を自分で見積もる必要があります。どちらの方法にも誤差があり、npj Digital Medicineの研究でも、専用に作られたAIアプリが日常生活での使用では一致の範囲が広いことが示されました。
発行元はPetros IT Solutions SRLです。誤りを見つけた場合は[email protected]までご連絡ください。