Estimations caloriques par photo
Comment marchent les compteurs de calories par IA
Comment marchent les compteurs de calories par IA ? Le pipeline en trois étapes, ses taux d'erreur sourcés, et pourquoi vérifier le résultat reste utile.
Guides
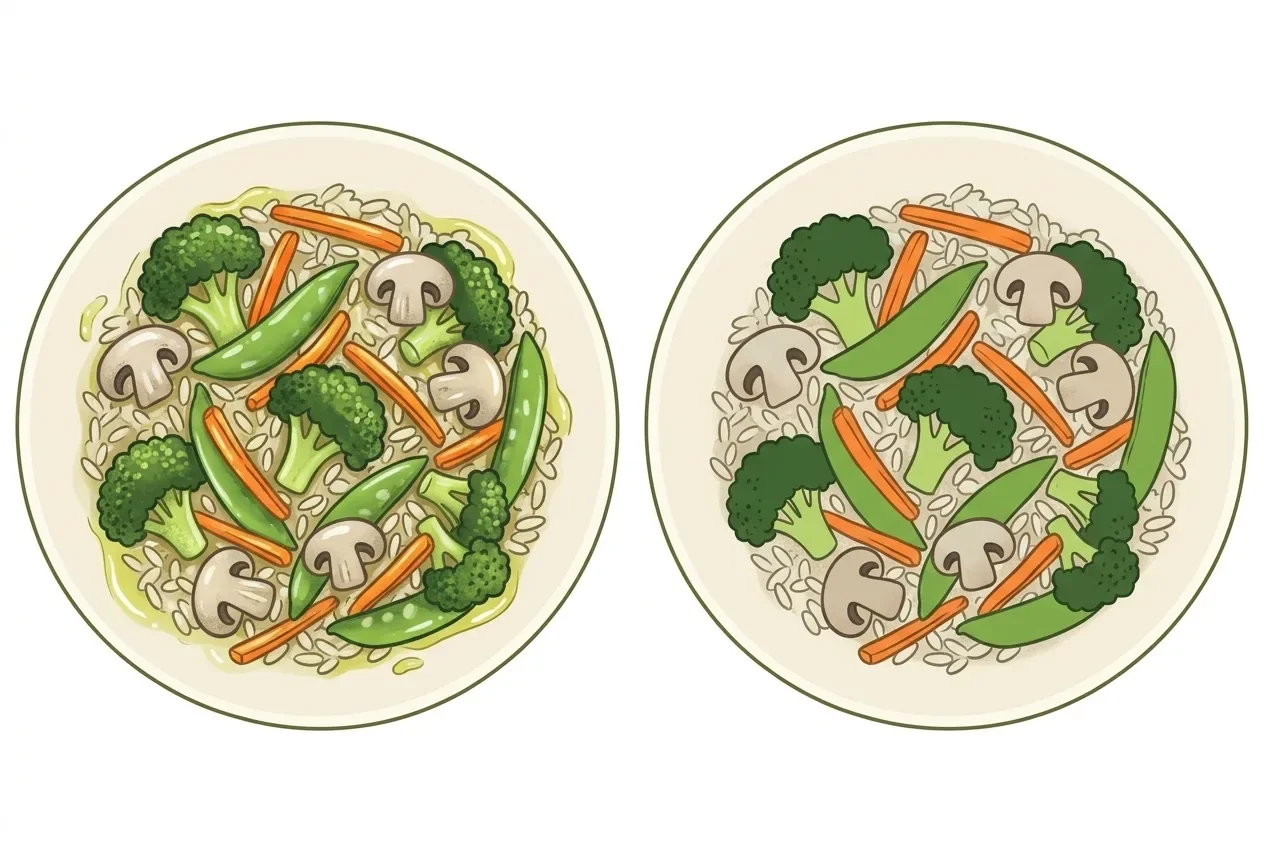
Les applications de calories par IA sont-elles fiables ? Pas avec certitude : elles estiment, et des études publiées montrent que cette estimation peut être proche ou décalée de plusieurs centaines de calories. Le sens de l'erreur n'est pas aléatoire. Les applications ont tendance à sous-estimer les calories totales et à surestimer les lipides, car une photo ne montre ni densité, ni poids, ni huile cachée. Ce mécanisme, plus que la qualité de l'application, explique l'essentiel de l'écart.
Une photo est une image plate de la lumière réfléchie par une assiette. Elle montre la forme, la couleur et une taille approximative. Elle ne montre ni la densité, ni le poids, ni ce qui est mélangé dans une sauce.
Deux bols de riz peuvent sembler identiques et peser différemment si l'un est tassé plus fort. Un sauté brillant d'huile ressemble presque à un sauté cuit à sec. À titre d'exemple illustratif, deux cuillères à soupe d'huile ajoutent environ 240 calories, invisibles sur une photo.
C'est pourquoi de meilleures photos ne suffisent pas à résoudre le problème. Un appareil photo capture ce que fait la lumière, pas ce que dirait une balance. Toute estimation issue d'une seule image doit deviner les éléments qu'elle ne peut pas montrer.
Un modèle de vision par IA analyse l'image et identifie les aliments présents. Il estime ensuite les portions à partir d'indices visuels : taille de l'assiette, hauteur de l'aliment, comparaison à des portions types.
À partir des aliments identifiés et des portions estimées, le modèle produit directement des chiffres de calories et de macronutriments. Cela diffère d'un scan de code-barres ou d'une recherche dans une base de données. À cette étape, il n'y a pas de comparaison avec un tableau de valeurs mesurées.
La personne examine ensuite ce que le modèle a produit. Elle peut modifier l'aliment identifié, la portion ou les chiffres avant d'enregistrer quoi que ce soit. C'est cette étape de relecture qui transforme une estimation photo en entrée enregistrée, plutôt qu'en simple supposition.
Cette séquence, identifier, estimer, vérifier, est la première étape pour comprendre où l'estimation peut se tromper et où la correction de l'utilisateur peut intervenir.
Une étude de 2026 publiée dans Nutrients a comparé des modèles d'IA à des diététiciens diplômés sur des photos standardisées de repas hospitaliers. Les estimations d'énergie et de glucides des modèles les plus performants, ChatGPT-4o et Gemini 1.5 Pro, corrélaient à plus de 0,8 avec les chiffres des diététiciens, souvent à environ 10 % près (Nutrients, DOI 10.3390/nu18060966). Tous les modèles de cette étude affichaient un biais moyen de surestimation des lipides supérieur à 20 %. Les protéines étaient elles aussi moins précises que l'énergie.
La raison tient à ce qu'un appareil photo peut voir. Les aliments riches en glucides comme le riz ont un rapport volume-calories assez prévisible. Les lipides sont souvent invisibles, dilués dans une sauce ou nichés sous d'autres ingrédients. Un modèle qui devine les lipides à partir de l'apparence a tendance à surcorriger.
Deux autres études chiffrent l'écart calorique total, au-delà des seuls lipides. Un résultat préliminaire présenté à NUTRITION 2026 a testé quatre applications commerciales, MyFitnessPal, LoseIt!, CalAI et Appediet, contre un premier ensemble de 102 repas préparés en cuisine métabolique, avec des ingrédients pesés au dixième de gramme, puis plus de 200 repas supplémentaires analysés ensuite. Les applications sous-estimaient les calories d'environ 250 à 345 kcal par repas, et d'environ 30 g de lipides (EurekAlert, NIH/NIDDK). Ce résultat est préliminaire et n'a pas encore été relu par les pairs.
Une étude relue par les pairs dans npj Digital Medicine a comparé une application d'IA nommée SNAQ à la méthode de l'eau doublement marquée, une référence pour mesurer l'apport énergétique, chez des femmes en situation d'obésité. L'application sous-estimait l'apport quotidien de 817 kcal en moyenne, soit un biais de 25 %, pour une moyenne mesurée de 3 004 kcal par jour. La concordance entre mesures répétées était quasi nulle, avec un ICC de 0,00 (PMC, npj Digital Medicine).
| Étude | Conditions | Comparaison | Résultat |
|---|---|---|---|
| NIH/NIDDK (préliminaire, NUTRITION 2026) | 102 repas pesés en cuisine métabolique, plus 200+ analysés ensuite | 4 applications commerciales vs ingrédients mesurés | Sous-estimation de 250 à 345 kcal, environ 30 g de lipides |
| npj Digital Medicine | Vie réelle, femmes en situation d'obésité | 1 application d'IA (SNAQ) vs eau doublement marquée | Sous-estimation de 817 kcal par jour, 25 % |
| Nutrients | Photos standardisées de repas hospitaliers | Modèles d'IA vs diététiciens diplômés | Énergie à environ 10 % près ; lipides surestimés de 20 % ou plus |
La tendance : les photos contrôlées d'une seule assiette donnent les estimations les plus proches. Les repas en vie réelle, avec plusieurs plats, donnent les écarts les plus grands.
Une étiquette imprimée paraît plus solide qu'une estimation photo, mais la règle qui l'encadre joue dans un sens précis.
Selon la règle américaine 21 CFR 101.9(g) de la FDA, les calories, lipides totaux, acides gras saturés, acides gras trans, cholestérol et sodium sont des nutriments de Classe I. Ils ne peuvent pas dépasser 120 % de la valeur déclarée sur l'étiquette. Le règlement ne fixe aucun plancher contre une sous-déclaration.
Le nombre de calories affiché peut légalement être jusqu'à 20 % supérieur à la valeur réelle mesurée en laboratoire, sans limite basse. Les protéines, vitamines, minéraux et fibres alimentaires sont des nutriments de Classe II : ils doivent atteindre au moins 80 % de la valeur déclarée, sans plafond.
En Union européenne, le règlement (UE) n° 1169/2011 (INCO) encadre ce qu'une étiquette doit déclarer, mais fixe ses propres tolérances, différentes de celles de la FDA. Ce n'est pas une accusation d'imprécision. C'est un simple contexte : même un chiffre calorique testé en laboratoire comporte un plafond intégré, pas une garantie d'exactitude. Une estimation photo et une étiquette imprimée sont toutes deux des approximations, avec des sources d'erreur différentes.
Aucune des deux méthodes n'est exempte d'erreur. La saisie manuelle, rechercher un aliment dans une base de données et indiquer une portion, dépend de la capacité de la personne à choisir la bonne entrée et à estimer correctement sa propre portion.
La saisie par photo transfère ce travail au modèle. Il fait face au même problème central : il ne peut ni peser l'aliment, ni voir à l'intérieur d'un plat.
Une étude portant sur une application de recherche avec repères visuels, goFOOD Lite, a montré que sur 468 photos enregistrées, 60, soit 12,8 %, ont dû être écartées en raison d'erreurs de capture. Les causes incluaient un repère de référence manquant ou une assiette non entièrement visible (JMIR mHealth and uHealth, DOI 10.2196/24467). C'est une source d'erreur distincte du modèle d'IA lui-même, dans un système conçu spécifiquement pour réduire les erreurs de capture.
Aucune des deux méthodes n'élimine l'approximation. La différence tient à l'endroit où elle se produit : dans l'estimation de portion d'une personne, ou dans la lecture d'image d'un modèle.
Considérez une estimation photo comme un premier aperçu rapide, pas comme un chiffre définitif. Pour une assiette simple et unique, les estimations se rapprochent du jugement d'un observateur entraîné, selon l'étude hospitalière de Nutrients. Pour un plat maison composite avec sauce ou huile, l'écart tend à s'élargir, selon les résultats du NIH/NIDDK et de npj Digital Medicine.
Plusieurs éléments faussent discrètement le résultat :
Pour un chiffre plus précis sur un plat maison, mieux vaut le construire ingrédient par ingrédient à l'aide du calculateur de calories par recette. Une fois le total connu, cet outil gratuit répartit les calories en portions, sans avoir besoin d'une estimation photo pour un plat partagé.
La saisie par photo d'Avocalo fonctionne comme décrit dans cet article. Photographiez un repas ou choisissez une photo dans votre galerie, et un modèle de vision par IA identifie les aliments et estime les portions, calories, protéines, glucides et lipides à partir de l'image.
Cette estimation n'est pas comparée à une base de données nutritionnelle. L'application ne pèse pas les aliments et ne voit ni l'huile cachée, ni la sauce, ni la portion exacte. Vous vérifiez et modifiez le résultat avant de l'enregistrer.
Pour les aliments que vous préférez rechercher directement, Avocalo propose aussi la saisie manuelle : recherchez dans une base de données alimentaire construite à partir d'Open Food Facts, de l'USDA FoodData Central et de tables de composition nationales, et réutilisez vos aliments récents ou fréquents. Utilisées ensemble, les deux méthodes couvrent mieux une journée d'alimentation que l'une seule. Rendez-vous sur Avocalo pour trouver l'application sur l'App Store ou Google Play.
Les études citées ont testé la performance des applications à un instant donné, pas leur apprentissage sur la durée. Aucune des recherches citées n'a mesuré si la précision s'améliore avec un usage prolongé. Une affirmation sur l'apprentissage des habitudes d'un utilisateur nécessiterait sa propre étude pour être vérifiée.
Les études citées ne testent pas cette pratique précise, il n'existe donc pas de réponse sourcée ici. Ce que montre la recherche, c'est que la visibilité des portions et des ingrédients, plus que le moment de la photo, explique l'essentiel de l'erreur. Une photo claire montrant l'assiette entière répond au problème d'erreurs de capture identifié par l'étude goFOOD Lite.
Les applications utilisent des modèles d'IA différents, et l'étude Nutrients a constaté de réelles variations entre modèles sur les mêmes photos standardisées. ChatGPT-4o et Gemini 1.5 Pro corrélaient à plus de 0,8 avec les valeurs des diététiciens, mais pas de façon identique, et tous les modèles surestimaient les lipides à des degrés différents.
Pas toujours. La saisie manuelle supprime l'approximation de l'IA mais dépend du choix de la bonne entrée dans la base et de l'estimation de la portion par la personne elle-même. Les deux méthodes comportent des marges d'erreur, et l'étude npj Digital Medicine a trouvé de larges écarts de concordance même pour une application d'IA conçue spécifiquement à cet effet, en usage réel.
Publié par Petros IT Solutions SRL. Une erreur repérée ? Écrivez à [email protected].